从尹光新歌到AI声音法律问题
从AI歌手翻唱到AI语音合成,系统分析AI语音技术在著作权、表演者权和人格权方面引发的各类侵权法律问题。
AI声音
在今年以来已经是成为人工智能大热话题之一
在2023年的国庆假期,笔者无意中听到了尹光的一首新歌 —— 《Dear Myself》
因为近年都很少特地留意香港地区的新歌
只觉得曲风和以前尹光的风格非常不同
后来搜索了歌曲MV与歌词细看
才发现是一首关于尹光个人发展历程以及寄望新技术的歌曲
其中最大的创新(甚至可能是目前全国乐坛真人唯一)
就是本人与自己的AI声音共同合唱
标题中的feat. Wan K.
Wan K.就是尹光AI声音的代号
AI声音作为目前AIGC其中一个主流输出内容
其权利归属一直处于一个模糊的地带
究竟AI声音(或者说AI声音训练文件)的权利归属人是谁
使用训练的AI声音是否侵权
仍存在争议之处
1、尹光与他的新歌
相信粤语地区,尤其珠三角的年纪较为成熟的读者
都会知道尹光是谁
尹光(英语:Jackson Wan Kwong,原名吕钖杨),越南华裔,是香港男歌手及演员,有“庙街歌王”之称。
他的歌以歌词较为“口水”和“粗俗”而闻名,但同时也非常敢于尝试各种音乐新风格
如果不认识他,也可能会对以下歌词有所耳闻(因属于QQ音乐VIP歌曲,故无法直接在文章内分享音频):
《荷里活》
喂喂荷里活有间大酒店
有三个肥婆呀学踢波 学踢波
你又踢 佢又踢 卒之就踢左落河
《你阿妈大减价》
你阿妈 大减价 益你阿爸
养家日夜捱 确唔易
你阿妈 大减价 益你阿爸
冇家用还有三餐
2023年6月,有香港网民制作出了“AI尹光”,并利用它翻唱了香港歌手姜涛的《Dear My Friend》、林家谦的《一人之境》等歌曲,随即在网上疯传。由于AI尹光唱功惊人,网民更表示“好听过原唱”,大家甚至狂推真人尹光翻唱。对此,「真.尹光」在6月9日于社交平台发帖:
“这两天收到大家好多消息,很多谢大家!尹光始终是尹光。 #由头到尾我们都是做回我自己 #有时悲有时喜有时小刀刺大腿 #不过你还有我我还有你 #尹光都还是尹光”
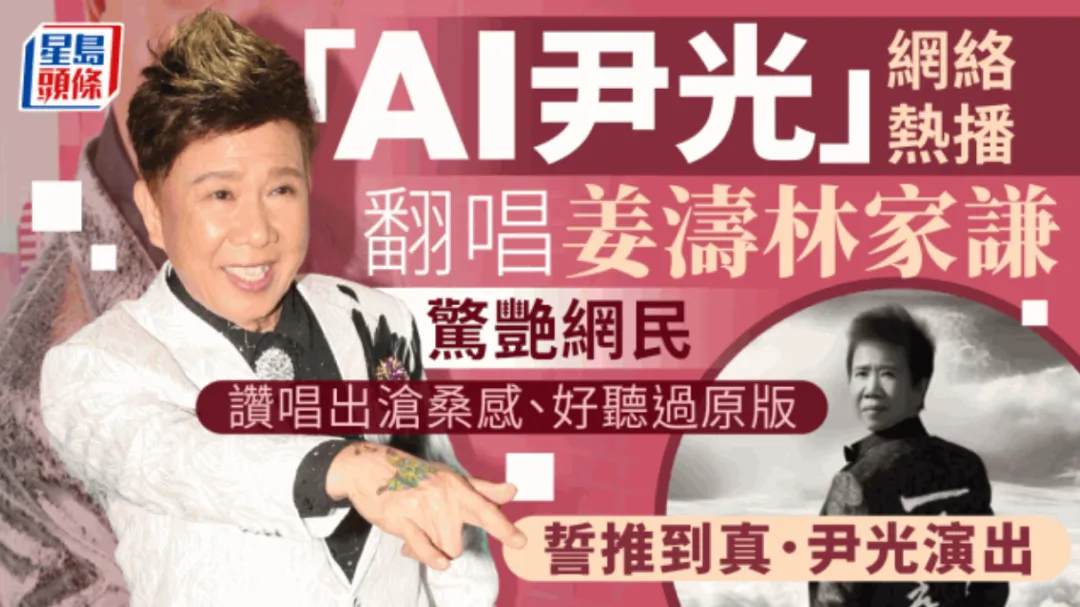 香港媒体“星岛头条”
2023年9月,尹光正式推出了新歌《Dear Myself》
除了歌词通过串联尹光各首成名曲的歌名,回顾了尹光的个人经历外
还突破性使用了尹光自己的AI声音进行合唱
在MV中也展示了自己的AI声音形象
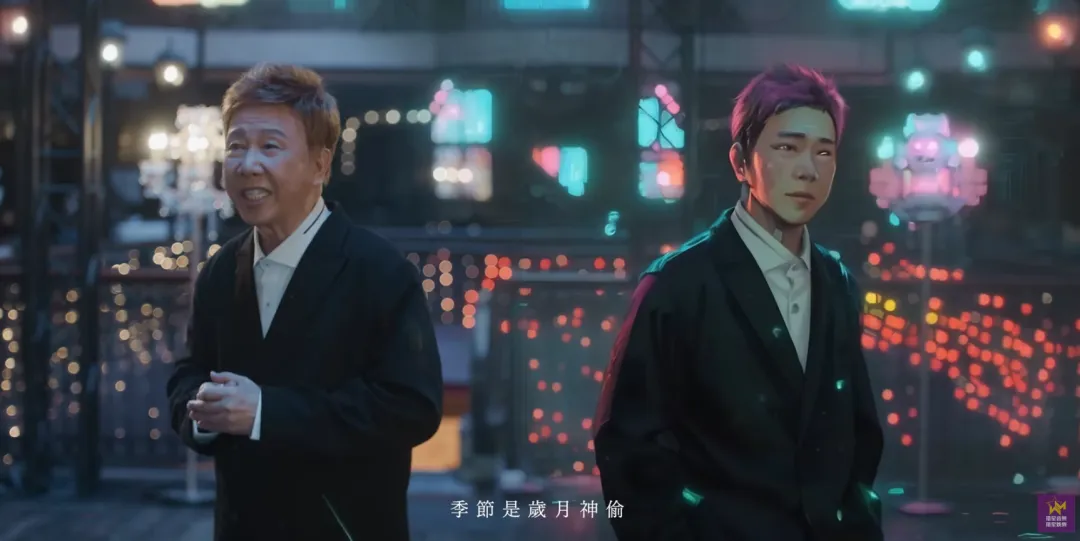
B站上的网友转载MV链接: 【【真·光B】尹光 feat.Wan K.《Dear Myself》|Official MV】 https://www.bilibili.com/video/BV1RN4y1Q74r/?share_source=copy_web&vd_source=1dd9c2c50090b91a5043ac50c2d4c857
其中歌词中最动人的一句莫过于
我唱着无无聊聊从未太闪耀
我在唱日日夜夜愿搏你一笑
到了我声线亦折旧了
我把这个使命过继AI了
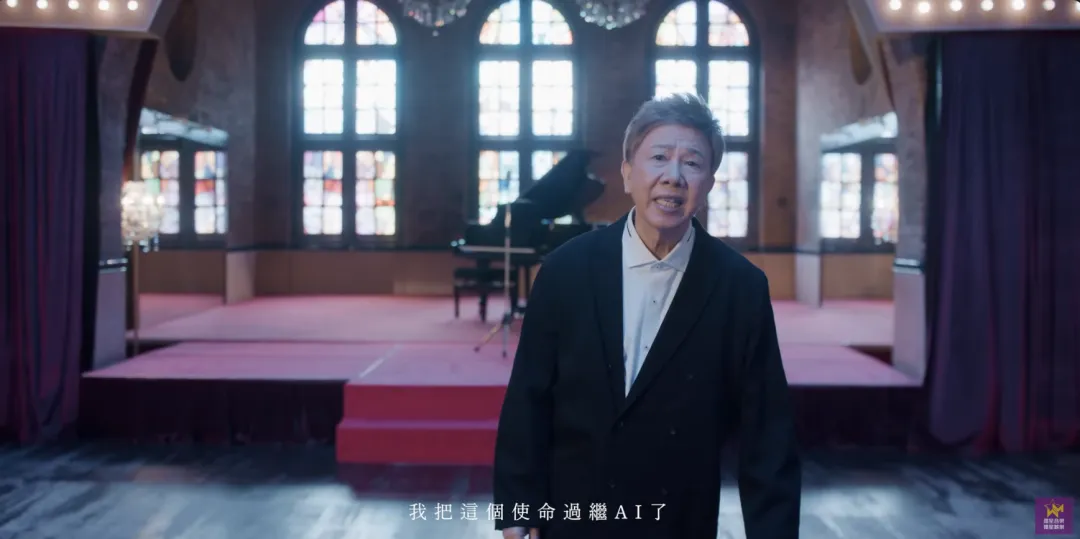
尹光的一生从未获得过主流的奖项(“从未太闪耀”)
唱的都是“低俗”的歌曲,目的是引人笑(“愿搏你一笑”)
当等到老了再也唱不动了(实际他已经74岁了)
那就由AI尹光继续履行这个给大家带来欢乐的使命
与目前很多主流“创作者”都在抵制AI不同 尹光作为老一辈歌手,反而选择了直接拥抱AI 并在歌中肯定了AI在延续自己“使命”的作用可谓秉承了其一贯的“新潮”
AI尹光是否能取代尹光呢? 并不见得
但大家反而会因为AI尹光 而记得尹光本人
当然尹光演唱会发布会中宣布了尹光是首位注册AI声音的香港歌手,日后任何人要用尹光AI声音,也必须先经过尹光同意。
尹光开心地表示感谢大家给面子,自己才能成为第一人:“公司说要注册,否则 出现太多也不知哪个版本才是 ,现在有《一人之境》、《Dear My Friend 》几首歌已经够听,太多便不值钱,哈哈!”
2、AI声音是什么
在分析AI声音的法律问题之前
循例我们先来了解一下什么是“AI声音”
目前AI声音与AI大语言模型、AI绘画类似
都是基于算法模型进行训练和生成(推理)
AI声音目前常见有两种方案:TTS和SVC
TTS(Text-to-Speech)是一个非常成熟的方案,目前各类主流的AI配音方案(“注意看,这个男人叫小帅”),基本基于TTS而来。但TTS的缺点也比较明显,停顿、语调、语气、多音字等方面会让人清楚认知到这是AI声音(“机械感”)。
SVC(Singing Voice Conversion)则是一个比较新的方案,比起TTS直接读文本的方式,它更像是一个“变声器”,可以直接把某段音频转变成另一种音色,这使得可以直接利用原本音频的语气语调等“人类特征”,减少了“机械音”的感觉。目前主流的AI歌手方案就是基于这个。
无论TTS还是SVC,训练所需的材料和训练过程都是类似的
均是通过获得干净的声音文件后,通过训练者所选择的算法模型
计算声音的特征后,生成与这个特征符合的模型文件(AI声音模型)
训练完成后
TTS是利用这个模型直接“朗读”文本
SVC则是分析原音频人声与模型特征的区别,把原音频人声“转变”得更符合模型的“声线”
3、AI声音在我国的保护
我国民法典中,已有对自然人声音进行保护的约定:
《民法典》 第一千零二十三条
对姓名等的许可使用,参照适用肖像许可使用的有关规定。
对自然人声音的保护,参照适用肖像权保护的有关规定。
参照《民法典》中肖像权的条款进行“强行”调整后,可以大致得出以下关于“声音权”的内容(注:以下为方便浏览阅读的结果,并非是实际存在的法律条文):
自然人享有声音权,有权依法制作、使用、公开或者许可他人使用自己的声音。
任何组织或者个人不得以丑化、污损,或者利用信息技术手段伪造等方式侵害他人的声音权。未经声音权人同意,不得制作、使用、公开声音权人的声音,但是法律另有规定的除外。
未经声音权人同意,声音作品权利人不得以发表、复制、发行、出租、展览等方式使用或者公开声音权人的声音。
合理实施下列行为的,可以不经声音权人同意:
(一)为个人学习、艺术欣赏、课堂教学或者科学研究,在必要范围内使用声音权人已经公开的声音;
(二)为实施新闻报道,不可避免地制作、使用、公开声音权人的声音;
(三)为依法履行职责,国家机关在必要范围内制作、使用、公开声音权人的声音;
(四)为展示特定公共环境,不可避免地制作、使用、公开声音权人的声音;
(五)为维护公共利益或者声音权人合法权益,制作、使用、公开声音权人的声音的其他行为。
AI声音是否构成侵权的讨论核心,笔者认为就以下两点:
-
训练AI声音是否属于“伪造”
-
使用AI声音模式生成音频文件,是否属于“使用声音权人的声音”
“伪造”问题
与AI绘画不同
如果说AI绘画是基于“共性”进行的再现
生成的都是某些画风或内容“共性”的组合
那AI声音则是对某个声音“特征”的再现
目的是生成与“特征”一致的声音(且AI声音的最终优化目标必然是某个声音的绝对再现)
与此类似的,就是“AI换脸”技术
如果是针对某个特定人物的AI声音训练,目的是重现这个人物的声音,通过这个声音去输出特定内容的音频文件(应该不会有人训练了但不输出)
则无论从技术目的还是使用目的来看,可能会符合“伪造”的标准,构成对声音来源者的侵权。
不过
当使用多个不同的声音来源,混合训练成诸如“最美的声音”、“某地区男女生常见的声音”等的声音模型,新声音模型基于声音来源的“特征”,且产生的结果与任何一个声音来源都不构成相似时,笔者认为这会构成例外,不会形成侵权的后果。
使用问题
对于AI声音的使用,笔者认为目前主要存在以下几种方向:
-
冒充某个人物,实施违法行为(目前已有基于AI换脸+AI声音实施诈骗的案例)
-
用于娱乐(例如AI歌手)
-
节省商业费用(利用专业的配音演员声音,为自己的作品配音)
第一种不用展开讨论,相信大家都可以知道是侵权的
第二种,初看好像是一种合理使用
尤其视频网站上的大量AI歌手视频
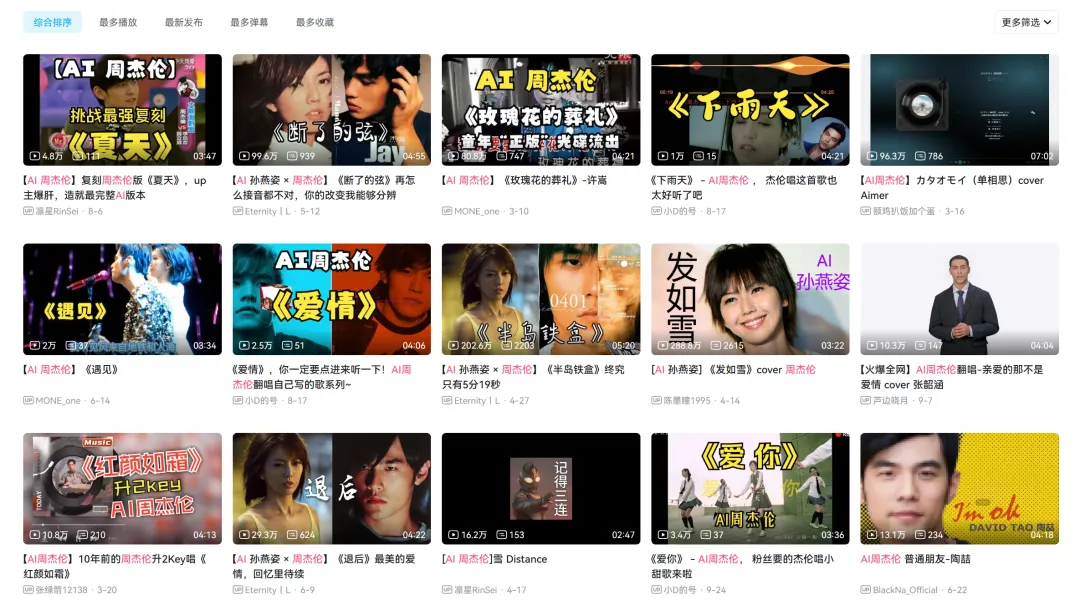
投稿人没有因此获得收益(视频播放量激励和充电先不讨论)
更像是只是“为了个人欣赏与学习”而制作的视频
但很可惜
AI时代与以前的“肖像权”(或者“声音权”)的“使用”已经不能一概而论
以前的“使用”,只会如“字面”一样为单纯的“使用”
但在上文,我们已经了解到,AI声音如要使用,必须要先进行训练。
当要使用AI声音进行翻唱(或其他使用行为)时,必然会存在“训练”的过程,且训练的目的为再现该歌手的声音,显然符合“利用信息技术手段伪造”的要件。
因此,就目前的法律而言
使用他人声音训练出与他人一致或明显相似的声音模型并进行使用
将很大可能构成民事侵权
要承担侵权责任
至于第三种情况,同理可知
同样构成侵权
还因实际使用情况不同,可能构成更多侵权责任:
-
如直接宣传“某某(无论真名还是昵称)配音”,则可能构成侵犯姓名权以及虚假广告;
-
如果直接不告知为AI生成的语音,打算打“近似声音擦边球”的,则可能构成违反《互联网信息服务深度合成管理规定》
第十七条 深度合成服务提供者提供以下深度合成服务,可能导致公众混淆或者误认的,应当在生成或者编辑的信息内容的合理位置、区域进行显著标识,向公众提示深度合成情况: ……
(二)合成人声、仿声等语音生成或者显著改变个人身份特征的编辑服务;
……
深度合成服务提供者提供前款规定之外的深度合成服务的,应当提供显著标识功能,并提示深度合成服务使用者可以进行显著标识。
然而
如果直接用训练好的模型 + 明确标注AI生成
但不明说训练声音来源
即使明显是侵权行为
在目前的技术条件下
并不容易查出侵权证据
毕竟声音乃至人脸
在全世界范围内存在近似在所难免
毕竟连尹光也表示
注册只是为了避免“出现太多也不知哪个版本才是”,只能注册一个专有版本
如何简单且有力证明“这个AI声音是我”
相信将会成为下一阶段法律和技术需要共同努力的目标方向
4、个人想法
谈完了法律问题
笔者还想谈谈一些个人的想法
尹光这首歌
除了让听众了解到AI声音外
还带来了一个思考
正如歌词中说到
“使命过继给AI了”
我们是否可以通过训练出一个自己的AI声音乃至AI人脸数据
让自己可以通过另一种方式
传达出自己的情感或者传递爱意?
例如 让难以表达自己情感的老父亲,通过AI声音读自己写给孩子的信,可能更为容易;
例如 让意外患病或遭遇事故的长辈,有机会通过留下的AI声音模型,“亲口”给后辈唱生日歌;
例如 《动森》的这个小故事 如果可以在信件中配上“母亲”的AI声音 是否会有更好的情感传达
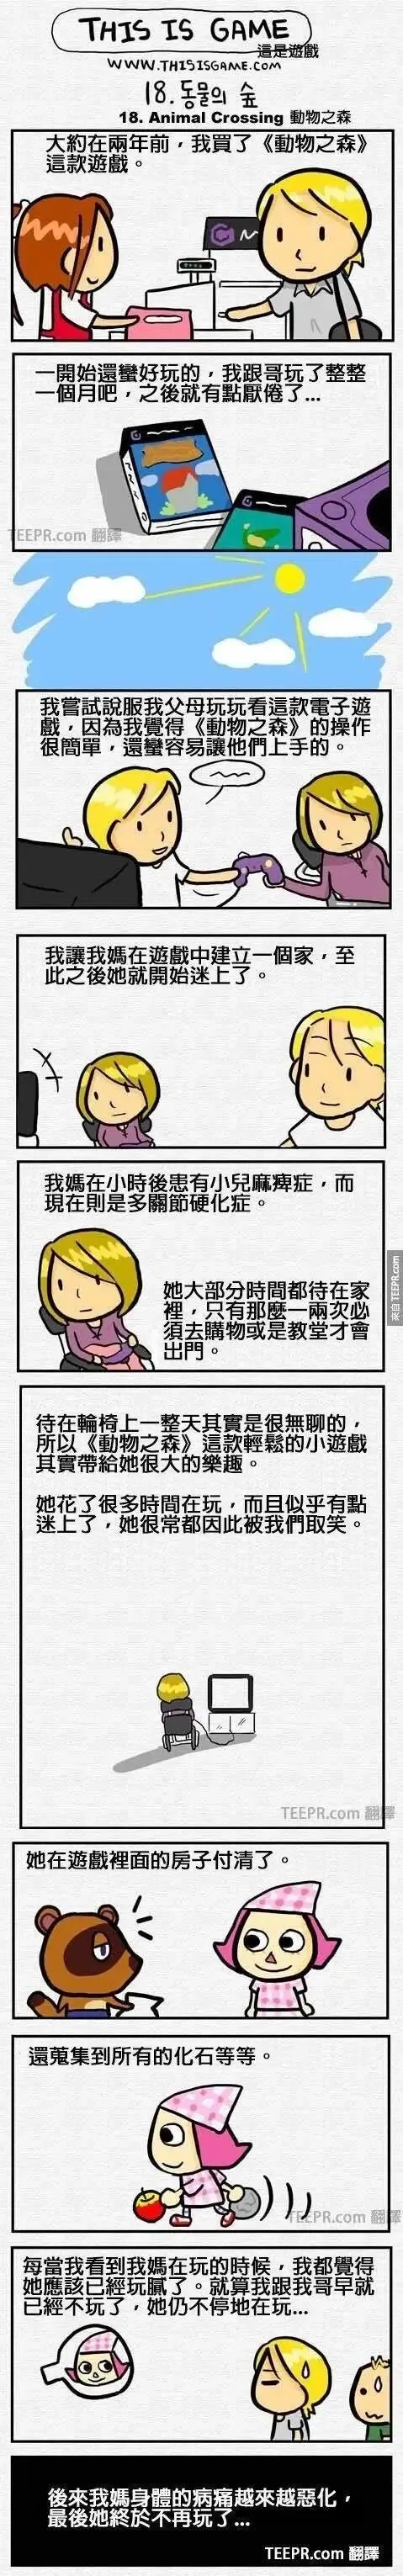
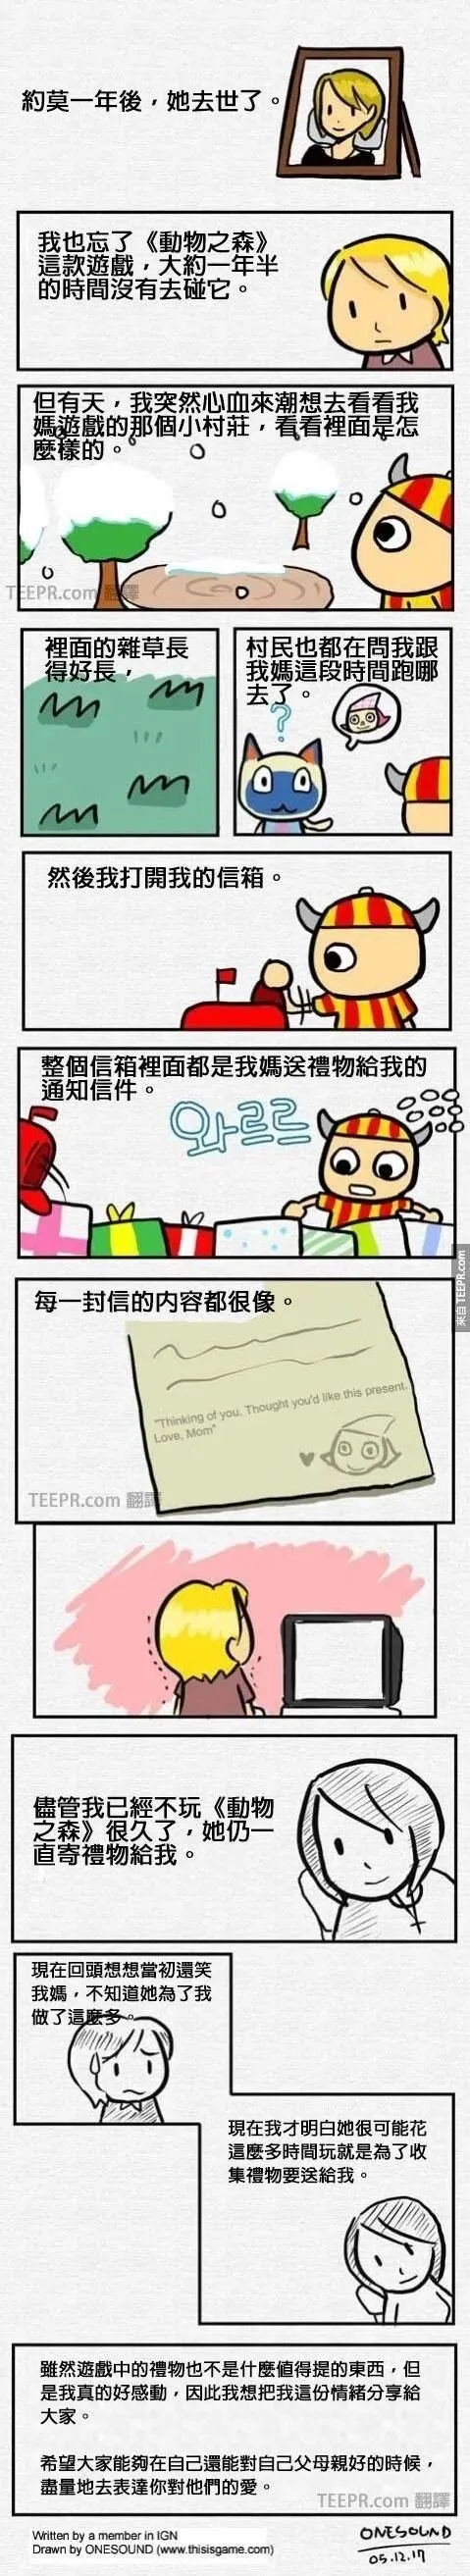
一个广为流传的《动森》小故事
还有另一个故事:
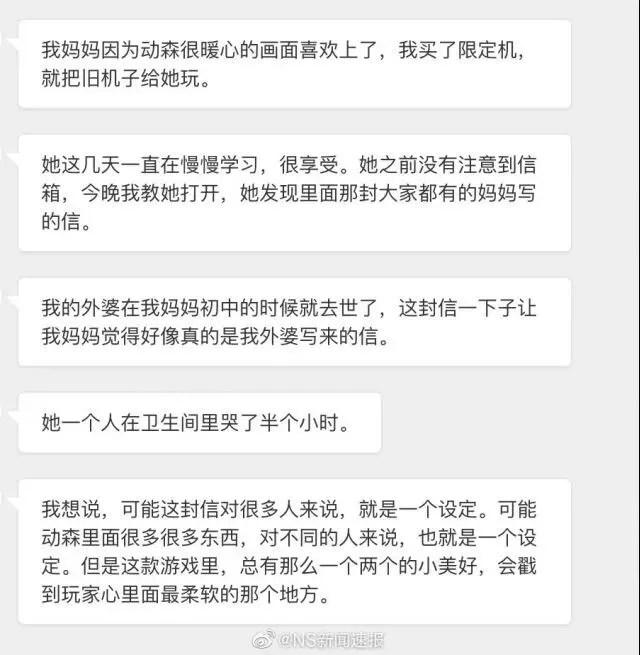
毕竟训练自己的个人AI必定不会构成侵权
同时还可以学尹光
提前把自己的AI声音模型注册
避免哪日被他人侵权
与其抵制AI
不如让AI成为自己的化身
成为“镜中的我”
镜中的我和我
是挚友
——《Dear Myself》
引用本文
李伯阳:《从尹光新歌到AI声音法律问题》,李伯阳律师网站,2023年10月23日,https://www.lslby.com/research/ai-voice-legal-infringement/